独立変数・従属変数・剰余変数とは|心理学実験の変数を 3 つに整理する
心理学実験の変数は、研究者が操作する独立変数、測定する従属変数、それ以外で結果に影響しうる剰余変数の 3 つに整理できます。見分け方、剰余変数が独立変数と一緒に変わる「混同(交絡)」がなぜ問題か、統制・無作為化・測定という 3 つの対処、変数を決めるときの手順を例で説明します。
心理学実験の計画を立てるときに、最初に整理するのが変数です。実験では「何を変えると、何が変わるか」を調べます。変える側を独立変数、変わる側を従属変数、それ以外で結果に影響しうるものを剰余変数と呼びます。ここでは 3 つの変数の見分け方、剰余変数がなぜ問題になるのか、変数を決めるときの手順を、音楽と作業効率の実験を例に説明します。
3 つの変数
| 変数 | 役割 | 例: 音楽が作業効率に与える影響 |
|---|---|---|
| 独立変数 | 研究者が意図的に変える(操作する)もの。原因の候補 | 作業中の音楽(あり / なし) |
| 従属変数 | 独立変数の影響を受けて変わると考えて測定するもの。結果 | 10 分間に解けた計算問題の数 |
| 剰余変数 | 独立変数以外で、従属変数に影響しうるもの | 参加者の計算の得意さ、時間帯、部屋の騒音、課題の難しさ |
独立変数が持つ値を水準と呼びます。上の例では「音楽あり」と「音楽なし」の 2 水準です。水準が 3 つ以上あってもかまいません(無音・クラシック・ポップスの 3 水準など)。
独立変数と従属変数の見分け方
「X が Y に影響する」という仮説なら、X が独立変数、Y が従属変数です。迷ったら、次の 2 つを確かめます。
- 研究者が決めているか: 参加者がどの水準に入るかを研究者が決めているなら独立変数です。参加者の回答や成績から得るものは従属変数です
- 時間の順序: 独立変数を操作した後に、従属変数を測ります。測った結果で水準を分けているなら、それは独立変数ではありません
性別や年齢、性格特性のように、研究者が操作できないけれど群分けに使う変数もあります。これらは参加者の属性による変数(被験者変数)と呼ばれ、要因として扱うときは準独立変数とも呼びます。独立変数と同じように分析には使えますが、研究者が操作も割り当てもしていないので、群の間の差をその変数の効果とは言い切れません。属性と一緒に変わる別の要因(年齢なら経験や世代)が原因かもしれないからです。
剰余変数がなぜ問題か
剰余変数そのものは、どの実験にも無数にあります。問題になるのは、剰余変数が独立変数と一緒に変わってしまうときです。
例えば、音楽あり条件を午前に、音楽なし条件を午後に実施したとします。午前の成績がよかったとき、それは音楽の効果でしょうか。午前のほうが頭が冴えていただけかもしれません。独立変数(音楽)と剰余変数(時間帯)が一緒に変わっているので、2 つの説明を区別できません。この状態を混同(交絡、confounding)と呼び、混同を起こしている変数を混同変数(交絡変数)と呼びます。
剰余変数が条件とは無関係にばらついているだけなら、結果の誤差は増えますが、条件の差の解釈は歪みません。一方、混同があると、どれだけ大きな差が出ても、独立変数の効果だと主張できなくなります。
剰余変数への 3 つの対処
| 方法 | やること | 例 |
|---|---|---|
| 統制(一定に保つ) | 剰余変数の値を全条件で同じにする | 実験はすべて午後に行う。同じ部屋、同じ実験者、同じ教示文を使う |
| 無作為化 | 参加者をどの条件に入れるかをくじで決め、個人差が条件に偏らないようにする | 計算の得意な人が片方の条件に集まらないよう、無作為に割り当てる |
| 測定して分析に入れる | 統制できない剰余変数は測っておき、分析で調整する | 計算の得意さを事前テストで測り、共変量として分析する |
統制は、気づいている剰余変数に対しては確実ですが、統制した範囲でしか結果を主張できなくなります(午後に行った実験の結果は、午前にも当てはまるとは言えません)。また、気づいていない剰余変数には効きません。測っていない個人差までまとめて偏りを散らせるのは無作為化だけで、3 つは組み合わせて使います。無作為化の手順は無作為割り当ての記事で、何も操作しない条件を置いて比べる方法は統制群の記事で説明します。
同じ人に複数の条件を出すときは、条件の提示順も剰余変数になります。順番による影響は順序効果の記事にまとめています。
変数を決めるときの手順
- 仮説を 1 文で書く: 「音楽を聞きながら作業すると、計算の正答数が減る」のように、X と Y がはっきり分かる形にします
- 独立変数の水準を決める: 何と何を比べるのかを決めます。「音楽あり」の中身(曲、音量、歌詞の有無)も具体的に決めておきます
- 従属変数の測り方を決める: 「作業効率」は直接測れません。「10 分間に解いた計算問題の正答数」のように、観察・測定できる形に置き換えます。これを操作的定義と呼びます
- 剰余変数を書き出す: 従属変数に影響しそうなものを思いつく限り挙げ、それぞれを統制するか、無作為化で散らすか、測って分析に入れるかを決めます
- 混同が無いか確かめる: 独立変数の水準ごとに、剰余変数の値が変わっていないかを見直します。水準と一緒に変わるものがあれば、計画を直します
独立変数が 2 つ以上あるときの組み方は要因計画と交互作用の記事で、質問紙調査としての全体の流れは卒論アンケートの作り方の記事で説明しています。
Psynaut で使う場合
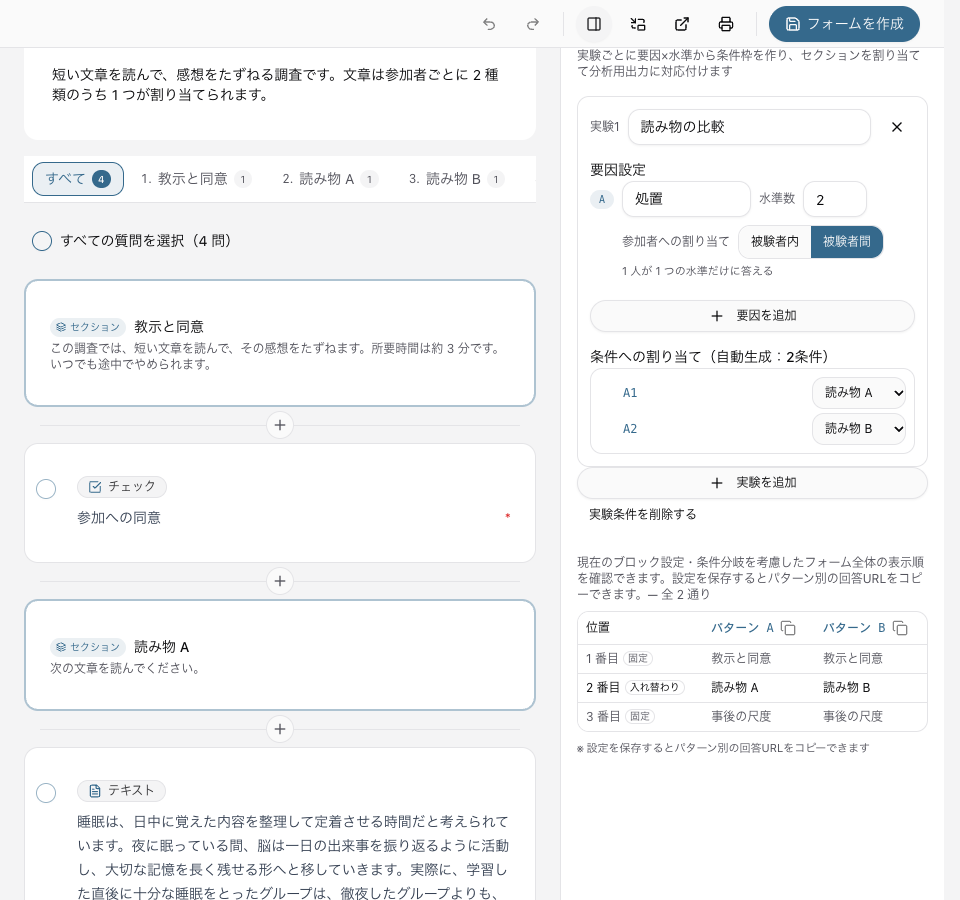
Psynaut では、「実験条件」で要因 (独立変数) と水準を登録し、要因と水準の組み合わせでできる条件枠に、その条件で見せるセクションを対応づけます。被験者間割付にすると、各参加者には割り当てられた条件のセクションだけが表示され、書き出す CSV の列名に条件コードが付きます。教示文や事後の尺度のように全員で同じにしたい部分は固定セクションにして、剰余変数をそろえます。
見本: 被験者間割付
ログインなしで開けます。回答も編集も保存されません。
参考文献
- Shadish, W. R., Cook, T. D., & Campbell, D. T. (2002). Experimental and quasi-experimental designs for generalized causal inference. Houghton Mifflin.
- Campbell, D. T., & Stanley, J. C. (1963). Experimental and quasi-experimental designs for research. Rand McNally.
この記事をシェアする
研究の準備を Psynaut でまとめる
フォームの作成から参加者の日程調整、分析用データの書き出しまで、無料プランで試せます。
次に読む記事
- 研究のヒント統制群(コントロール群)とは|何を統制するのか、どう作るか統制群(対照群、コントロール群)は、実験群と「調べたい操作の有無」だけが違う比較の基準となる群です。統制群が無いと排除できない 4 つの別の説明、無処置・プラセボ・積極的統制・待機群の違いと言えることの違い、実験群とそろえる 5 つの点、質問紙研究での統制条件の考え方を説明します。
- 研究のヒント要因計画と交互作用とは|2×2 デザインの読み方と結果の書き方独立変数が 2 つ以上ある実験を要因計画と呼び、2×2 デザインがその基本形です。平均値の表とグラフを使って主効果と交互作用の違いを説明し、交互作用があるときに主効果をどう解釈するか、条件数と人数の関係、F 値と効果量を含む結果の書き方をまとめます。
- 研究のヒント無作為割り当て(ランダム化)のやり方|単純・ブロック・層化の違いと人数のそろえ方無作為割り当て(無作為割付、ランダム化)は、参加者をどの条件に入れるかをくじで決める手続きで、条件の差を因果の証拠として主張する土台になります。なぜ必要か、単純・ブロック・層化の 3 方式の違いと使い分け、各条件の人数をそろえる工夫、来た順に分ける方法との違い、無作為抽出との違いを説明します。